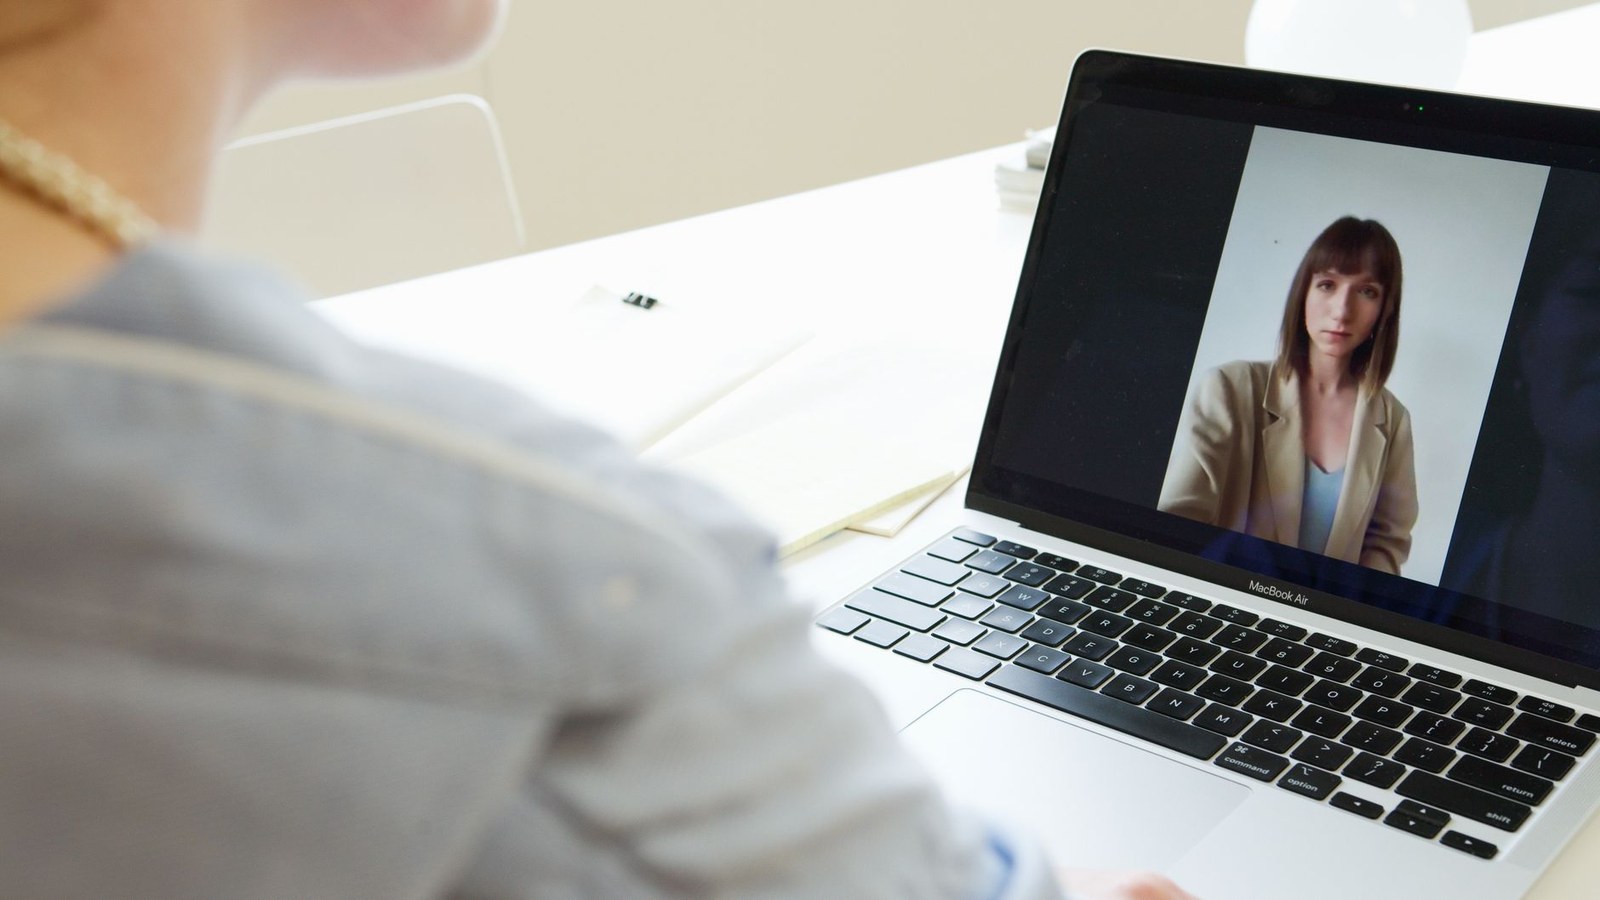
Tavus выпустила Phoenix 4.5 — новую модель для генерации реалистичных цифровых людей в реальном времени. Главное отличие от прошлых версий в том, что модель генерирует одним кадром не только лицо, но и голову, плечи, позу, торс, одежду и фон. Для рынка AI-аватаров это переход из категории «говорящая голова» в категорию «человек в кадре».
Кадр целиком вместо говорящего лица
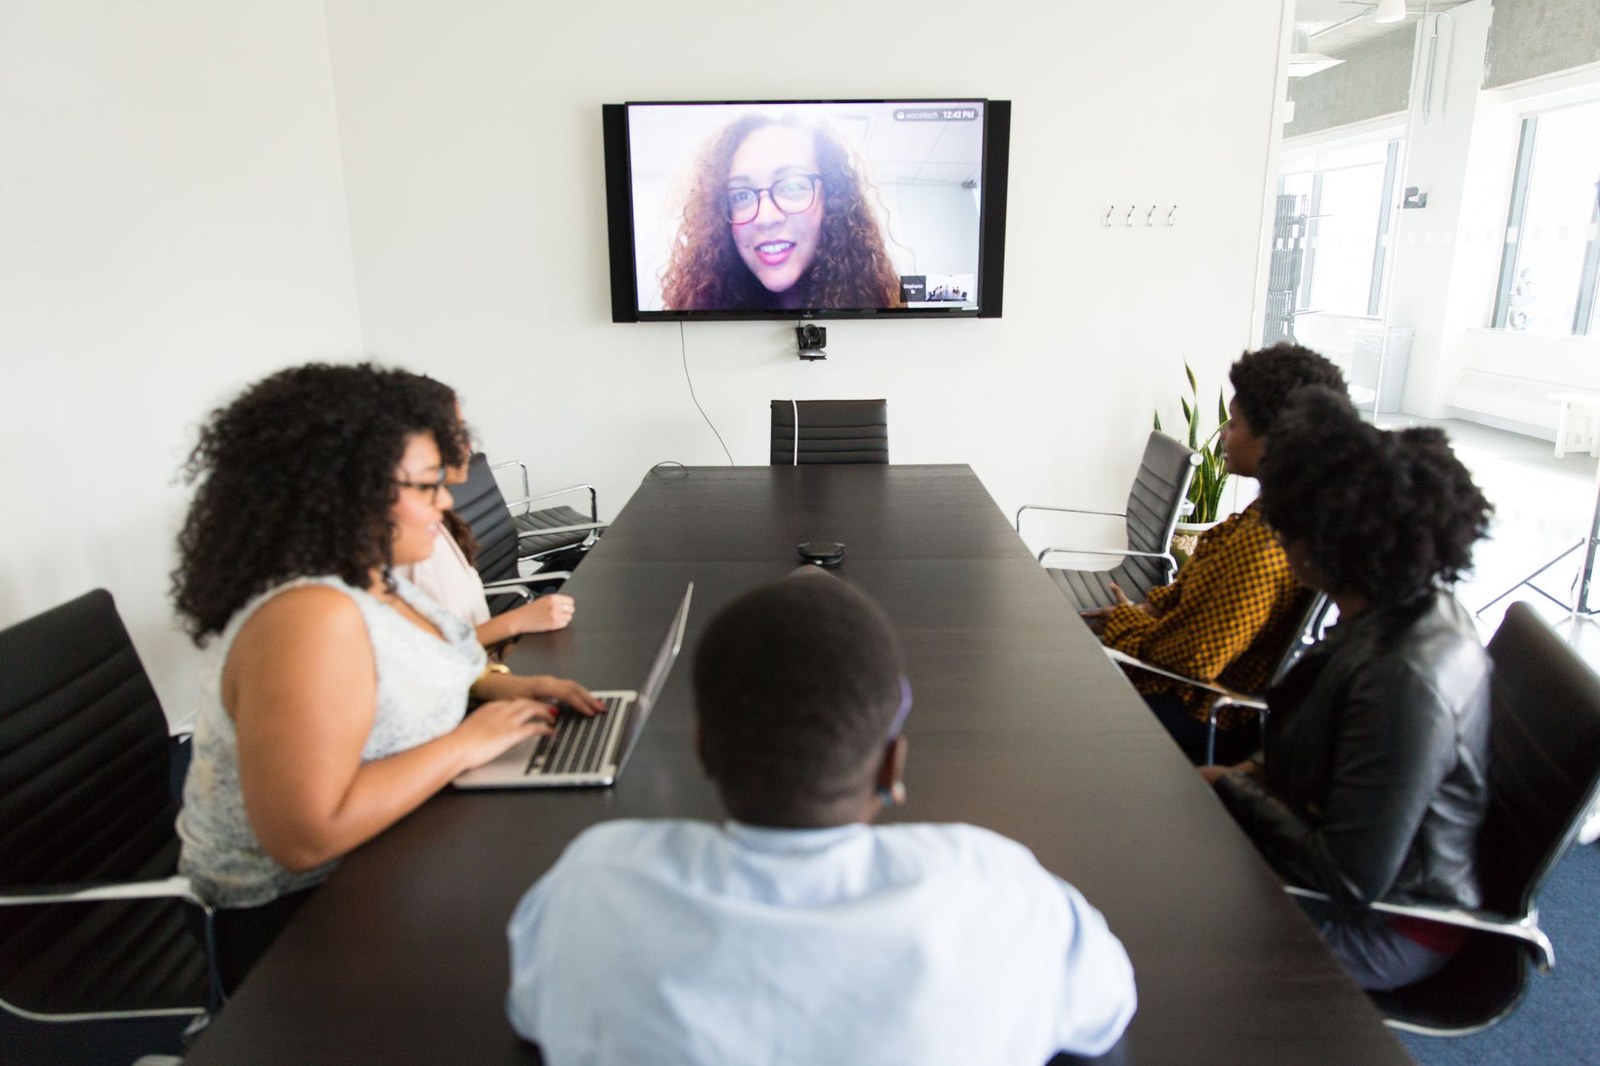
Раньше генеративные аватары, по сути, работали как анимация лицевой области: изображение лица накладывалось на статичное тело, а всё остальное в кадре оставалось неподвижным. Phoenix 4.5 генерирует всю сцену сразу, и именно поэтому поведение аватара выглядит намного естественнее во время разговора.
Что это даёт на практике:
- аватар меняет позу, а не сидит замороженным статистом;
- двигает плечами и головой в такт речи;
- показывает микроэмоции — мелкую мимику, которая обычно и выдаёт синтетику;
- продолжает реагировать, даже когда просто слушает собеседника.
Последний пункт недооценивают чаще всего. В живом диалоге человек большую часть времени молчит и слушает, и именно в эти секунды старые аватары превращались в маску. Если модель умеет держать поведение в режиме слушания, разговор перестаёт рассыпаться на «реплики аватара» и «паузы».
Задержка 134 мс и качество липсинка
Задержка от аудио до готового видео у Phoenix 4.5 составляет около 134 мс. По данным Tavus, это на 25% быстрее других моделей этого класса. Отдельно заявлено, что липсинк (синхронизация движения губ со звуком) относительно Phoenix 4 улучшился на 16%.
Цифры стоит читать трезво. 134 мс — это примерно та зона, где задержка ещё ощущается, но не мешает диалогу: собеседник не начинает перебивать аватара и не теряет нить разговора. Для чат-бота задержка в треть секунды выглядит провалом, для видеоаватара — вполне рабочей нормой. Именно поэтому гонка здесь идёт за десятки миллисекунд, а не за секунды.
Улучшение липсинка на 16% звучит скромно, но в этой задаче важна не абсолютная метрика, а порог, после которого мозг перестаёт замечать рассинхрон. Мы уже проходили это с генерацией видео: модели долго выдавали красивые кадры, которые невозможно было смотреть дольше пяти секунд. Здесь ровно та же логика — «реалистичность» решается физикой, а не разрешением картинки.
Свой аватар: минута на предпросмотр вместо часов ожидания
Второе большое изменение касается создания собственного цифрового двойника. Phoenix 4.5 умеет запускать новую личность почти сразу по одному изображению или видео. Предпросмотр появляется примерно за минуту, а финальное дообучение (fine-tuning — подстройка модели под конкретного человека) занимает около двух часов вместо четырёх раньше.
Сокращение времени обучения вдвое — это не про удобство, а про экономику. Когда аватар собирается за пару часов, он перестаёт быть дорогим артефактом, который заказывают раз в год. Его можно тестировать, откатывать, делать под каждый язык и каждый продукт. Быстрый предпросмотр за минуту здесь важнее самого обучения: ты сразу видишь, годится ли исходник, и не тратишь два часа на материал, который изначально не подходит.
Что это значит на практике
Тренд очевиден: аватары уходят из демо-роликов в интерфейсы. Живой цифровой человек с задержкой в треть секунды — это уже не «вау, смотрите, что умеет ИИ», а деталь продукта: ассистент в личном кабинете, ведущий обучающего курса, интерфейс поддержки.
И тут есть важный нюанс для тех, кто собирает продукты в режиме вайбкодинга. Качество аватара давно перестало быть ограничением — ограничением стал сценарий. Модель честно двигает плечами и показывает микроэмоции, но если твой аватар двадцать секунд произносит текст, который ты сам не стал бы слушать, никакой липсинк это не спасёт. Сначала — что и зачем говорит цифровой человек, потом — насколько реалистично он при этом выглядит.
Выводы
- Phoenix 4.5 генерирует цифрового человека целиком — голову, плечи, позу, торс, одежду и фон одним кадром, а не только лицо.
- Аватар меняет позу, двигает головой и плечами, показывает микроэмоции и продолжает реагировать в режиме слушания.
- Задержка аудио → видео около 134 мс: на 25% быстрее других моделей класса, липсинк лучше Phoenix 4 на 16%.
- Свой аватар запускается почти сразу по одному изображению или видео: предпросмотр примерно за минуту, дообучение — около двух часов вместо четырёх.
- Главный ограничитель больше не качество картинки, а сценарий и смысл того, что аватар произносит.